Filer och lagring
Files-sidan
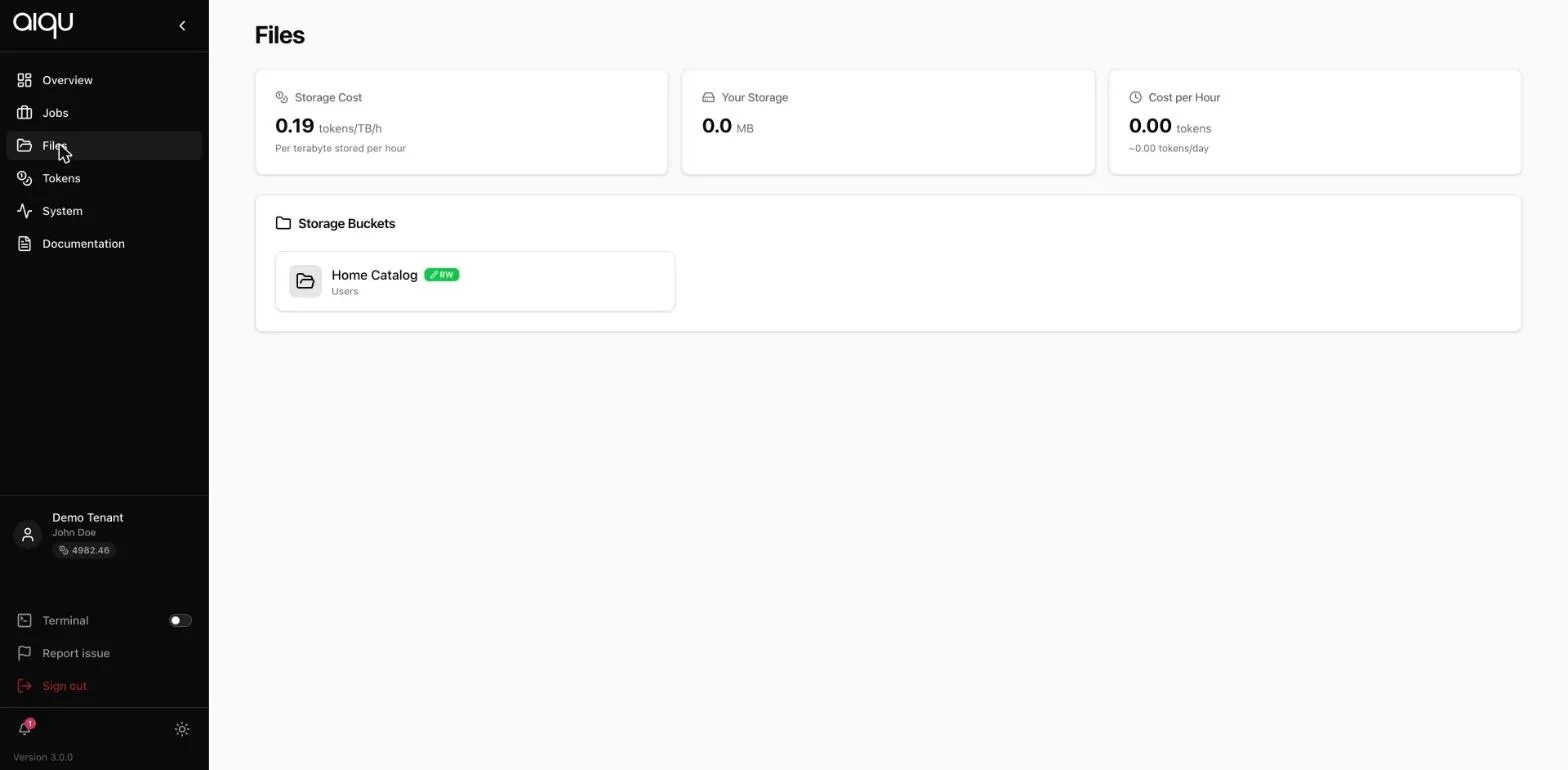
Section titled “Files-sidan”Storage cost, Your storage och Cost per hour högst upp: taxan per terabyte-timme, vad du använder, och vad det kostar. Lagring debiteras löpande, inte per jobb.
Under dem dina buckets, var och en med en åtkomstmarkering:
| Markering | Betyder |
|---|---|
| RW | Läs och skriv |
| RO | Skrivskyddad. Går att montera, men ditt jobb kan inte skriva till den |
Markera en bucket för att bläddra i den, ladda upp till den och ladda ner från den.
Att montera en bucket i ett jobb
Section titled “Att montera en bucket i ett jobb”- I formuläret, Folders to mount → + ADD.
- Välj collection och bucket.
- MOUNT.
- Justera sökvägen i containern om du vill ha den någon annanstans än förvalet.
Ditt jobb läser och skriver sedan den sökvägen som vilken katalog som helst, och det som ligger där efteråt ligger kvar.
Varför jobbformuläret visar färre buckets
Section titled “Varför jobbformuläret visar färre buckets”Det här är det enda verkligt förvirrande med lagring, så det är värt att säga rakt ut:
- Files-sidan listar varje bucket du har åtkomst till.
- Jobbformuläret listar varje bucket den valda kön kan nå.
En bucket ligger på en storage, en storage är kopplad till vissa köer, och ett jobb kan bara montera lagring dess nod faktiskt ser. Alltså kan en fullt synlig bucket vara omonterbar på en kö och helt i sin ordning på en annan.
När formuläret säger “No storage is attached to the … queue, so there is nothing to mount here” är dina val att välja en annan kö, eller att be en administratör koppla den lagringen till kön. Se Lagringsadministration.
Att arbeta med data
Section titled “Att arbeta med data”Att få in data. Ladda upp via Files-sidan för små saker. För stora dataset, montera bucketen i ett jobb och hämta inifrån containern. Nodens uppkoppling är oftast mycket bättre än din.
Att få ut resultat. Skriv dem till den monterade sökvägen och ladda ner från Files-sidan efter att jobbet tagit slut.
En praktisk uppdelning. Håll dataset i en skrivskyddad bucket som delas av teamet, och skriv utdata till din egen läs- och skrivbara. Då kan ett misstag i ett jobb inte förstöra datasetet.
# inne i containernpython train.py \ --data /datasets/imagenet \ --output /homecatalog/runs/$(date +%F-%H%M)Kostnader
Section titled “Kostnader”Lagring debiteras per terabyte-timme, löpande, oavsett om ett jobb kör. En bucket du fyllde och glömde fortsätter kosta. Files-sidan visar aktuell taxa och din löpande summa; Tokens-sidan visar vad som faktiskt debiterats.